在2026湾区半导体产业生态博览会(湾芯展)上,深圳江原科技有限公司技术市场副总裁鲍敏祺接受芯师爷采访时,反复强调一个理念:技术创新始终以商业可用为目标。这句话,比展台上任何一颗芯片的参数都更能解释江原的产品选择和市场路径。
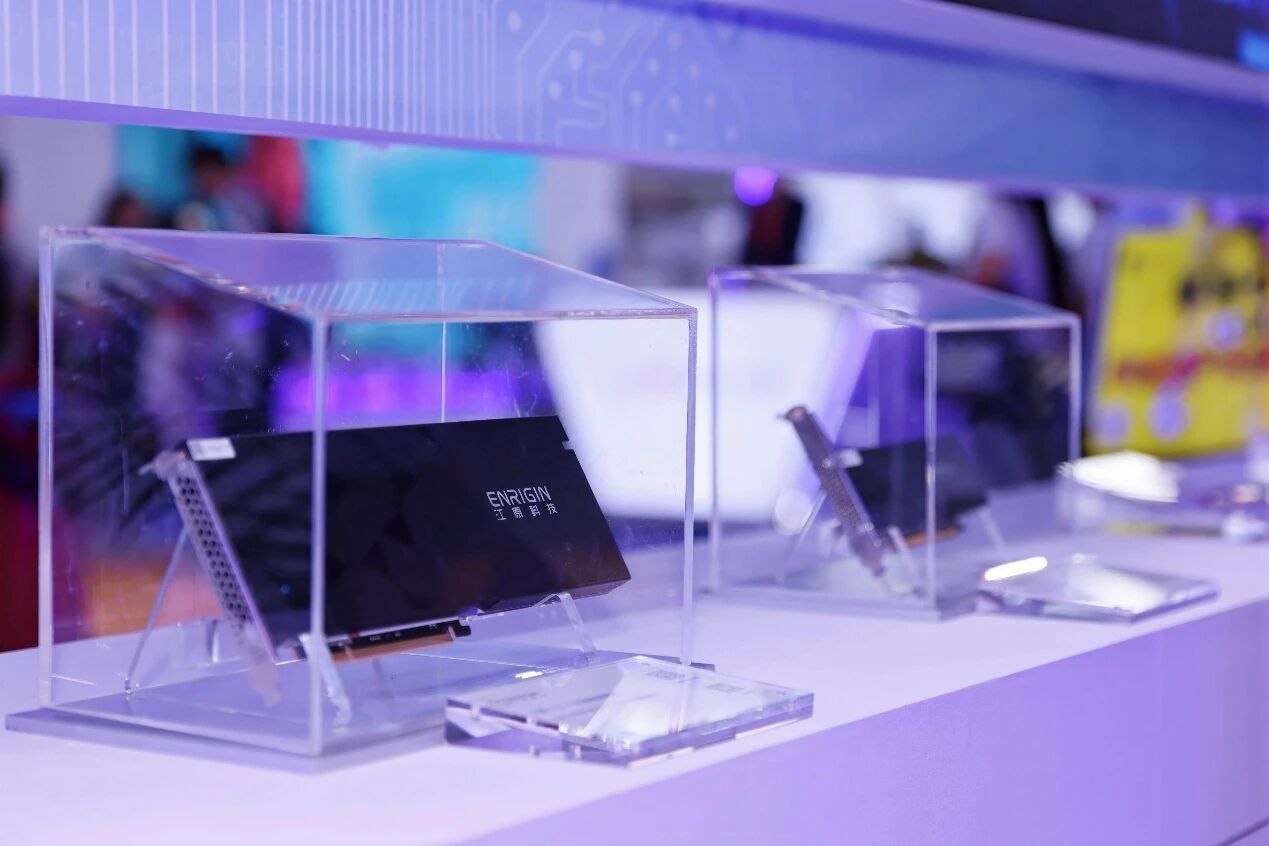
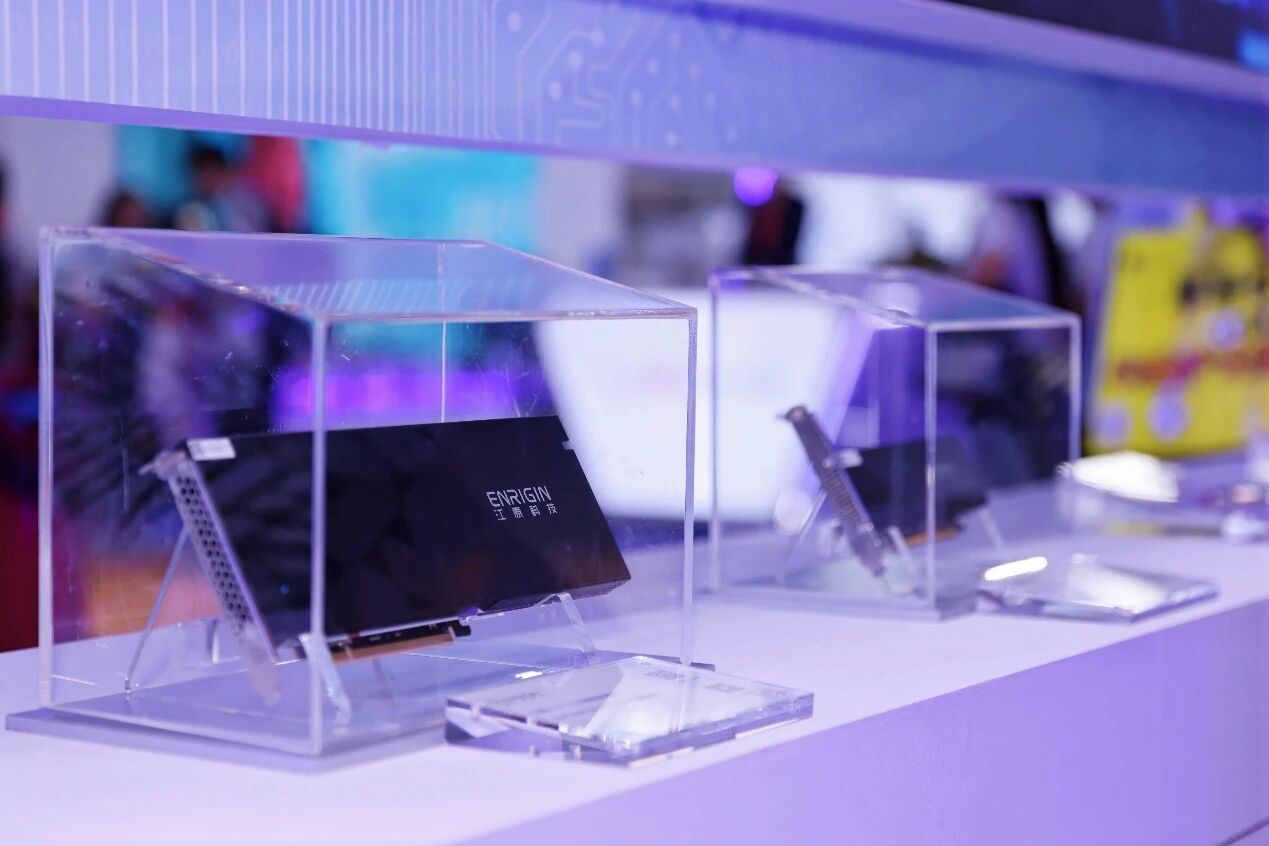
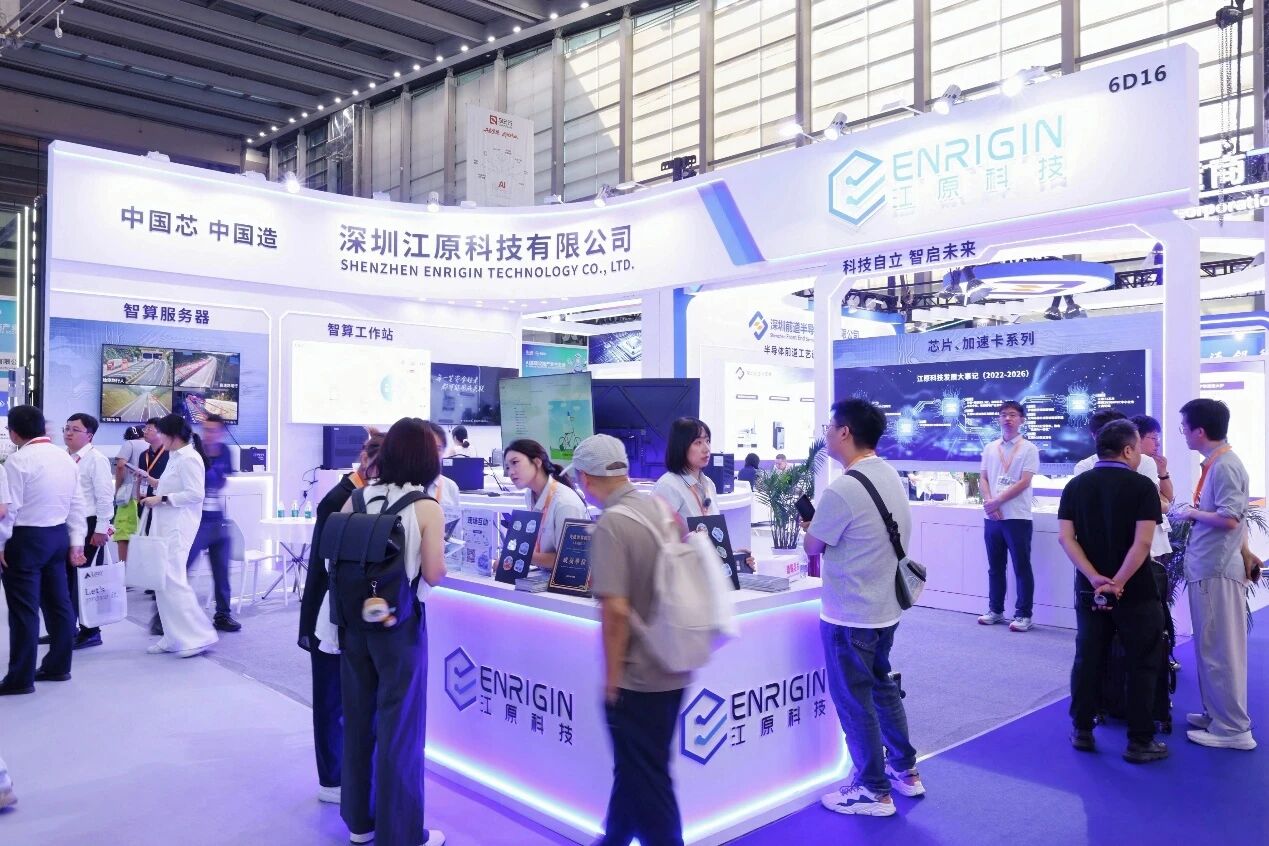
江原科技是一家专注于云边端全栈自研的国产AI算力公司,产品覆盖底层芯片、板卡、一体机、智算服务器以及上层软件栈,团队约260人,从指令集到软件栈实现全栈自研与自主可控。本届湾芯展,公司展出了基于第一代芯片江原D1开发的风冷与液冷一体机、16卡服务器,可完整支持DeepSeek满血版模型;基于江原D10/D10S-P1算力平台的机器狗作为具身智能场景演示;其中,面向云端万亿参数模型推理的自研旗舰芯片江原T1,继今年6月APEC中小企业工商论坛首次对外介绍后,再度成为本届湾芯展的展示重点,进一步呈现江原面向大模型推理的云边端全领域产品布局与技术方向。
如果只看展品,很容易把江原理解为又一家“芯片+一体机”的国产算力厂商。但芯师爷在采访中发现,江原真正想讲清楚的是一条更具体的路径:先做边端,把客户、场景和软件栈打通;再向云端延伸,让边端客户成为云边协同的天然承接方;最后用Chiplet统一架构把云边端产品矩阵拼起来。
一、展台切片:想秀的不是单点,而是云边端全矩阵
江原这次展台的“重点”并不难找。
量产主力是江原D10、D20系列一体机,覆盖风冷、液冷两种散热形态,可部署为16卡服务器,支持千亿参数模型是当前对外的旗舰用例。机器狗演示则承担另一层任务:告诉客户,同一颗边端芯片在具身智能这类低功耗、高实时性场景里也已经跑得动。压轴出场的,是第二代云端超大规格产品——按公司规划,新品发布后,江原将完成云边端全产品矩阵覆盖。
展台还呈现了本地会议转写、AI诊间听译、交通道路智能感知、企业级资金审计等垂直场景,以及麒麟软件、统信软件等生态伙伴成果。机器狗互动演示区依托自研江原D10S-P1算力平台,可实时完成环境感知、物体识别、深度测算。江原在本届湾芯展获得“技术创新企业·AI技术”官方荣誉认证。但在采访中,鲍敏祺没有把重点放在奖项和参数上,而是反复解释:边端侧国产算力已经完成从国造到规模化落地的市场验证,江原下一步将向云端延伸。
这也是理解江原的关键。它不在展台上罗列产品,而是以展品讲述自己的节奏:边端已能卖、能用、能交付,云端亦将于近期就位,中间则以软件栈、API 与 Chiplet 架构层层打通。
二、为什么先做边端:不是退路,是给云端铺路
多数国产AI芯片厂商会把云端训练或推理当作第一战场,江原却反过来,先从边端侧切入。这条路看起来慢,但采访中鲍敏祺算的是一笔很清楚的账。
云端市场客户高度集中、规格要求高,初期切入压力大;边端侧客户体量大、需求多以零散小批量采购起步,正好适合新产品积累验证与口碑。过去一年,江原已在边端侧适配100余家客户、177种应用。其中约60%集中在软件通信领域,以AI agent相关的SaaS类客户为主,这类客户对"数据不出域、低噪音运行"有明确要求;剩余40%分布在工业、EDA、航天、医疗、金融等传统行业,用AI替代标准化、重复性的人工环节。
边端芯片的设计逻辑也随之明确:相比追求极致能效,江原优先保证核心通用性,让同一颗芯片能覆盖十亿参数到千亿参数全系列模型的部署。代价是能效指标做了小幅让步,但避免了传统端侧芯片采用定制化ASIC、只能适配单一领域、无法跨场景复用的老问题。展台上那台机器狗,正是这条逻辑的延伸演示——同一颗江原D1,既能撑起16卡服务器的高密度推理,也能驱动桌面级静音机型与便携式AI PC。
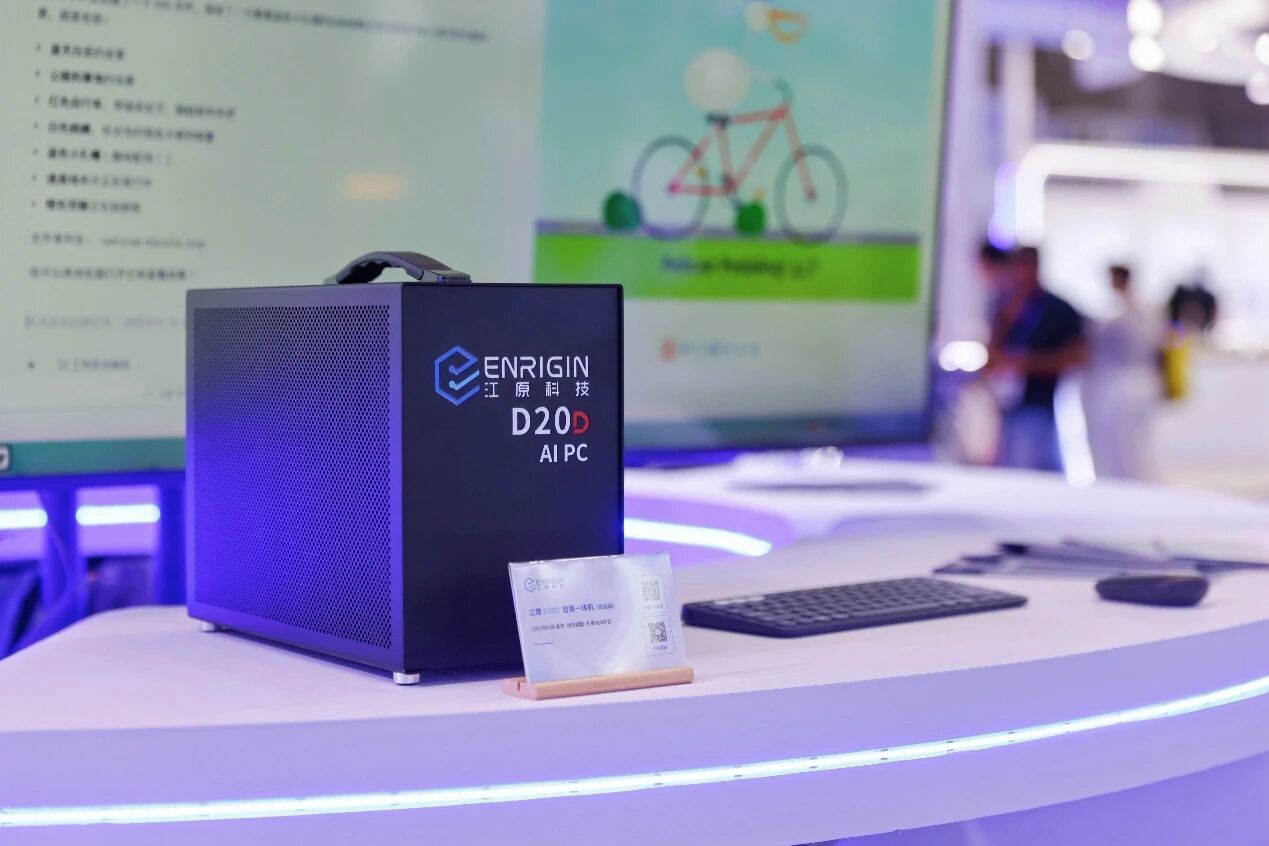
更关键的是,方案交付的颗粒度也在上移。江原的做法是联合上游 ISV 厂商,接入不同垂类领域经微调的模型,直接交付端到端的应用级体验。这是 SaaS 类客户愿意买单、传统行业客户也能用得起来的形态。
从经营视角看,边端最大的价值不只是“先用起来”,而是为云端铺好通路:已完成适配的边端客户,天然是后续云边协同算力的承接方——软件栈与API已经打通,客户从边端走向云端是需求自然生长的结果,不需要再为云端业务重新获客。采访中,江原也给出了一组市场判断:云端算力年增速不低于40%,海外厂商逐步退出国内推理、训练市场,需求缺口持续扩大;边端侧年增速约20%—30%,但玩家数量同步增长,单一厂商市场空间有限,需要绑定云业务增强抗风险能力。
这解释了江原为什么坚持“边端养云”:边端不是退路,而是入口。
三、国产化取舍:国际先进工艺代差,用架构、封装和软件找补
国产算力的成色,需要拆开来看。江原的硬底牌在供应链:最新量产的江原D1芯片已实现国内流片、国内封装、全链路国产材料配套,无对外依赖环节。鲍敏祺强调,国内成熟制程全链路目前已可自给自足、完成商业闭环,差距集中在最前沿制程——2nm等节点仍存在代差。
补差距的路径,江原没有选择正面硬冲制程,而是用高级封装、2.5D堆叠、异构集成与架构创新把差距找回来。江原D20AI加速卡的一卡双芯设计,就是这条路线上的具体产品:通过多颗芯粒聚合单卡的算力与带宽,满足客户对高算力、高带宽的基础需求。但性能表现与模型适配性强相关——Transformer这类容易切分的模型可以接近单芯水平,对时延敏感的模型则会有性能损耗。一卡多芯是国内厂商的通用路径,代价是必须配合强软件优化能力,硬件规格表本身不能直接等同于最终性能。
商业模型上,江原将 Token 成本主要拆分为硬件成本与电费两部分,并通过自主调控毛利、向地方争取电费补贴等方式压低整体成本。但江原同时强调,不能为压价而压价——算力质量必须满足客户的 SLA 与 SLO 要求,定价需对标大模型厂商的 API 成本。换句话说,国产算力的价格锚,最终系在了客户的替代成本上:客户换不换,取决于综合算下来贵不贵。
四、组织与生态:Chiplet和标准提前布局
在“人人扩表”的AI芯片赛道里,江原的研发规模显得克制。公司整体团队约260人,研发人员占比80%,明确拒绝使用“堆人”策略。鲍敏祺的解释是,单纯堆人可能引发商业模式和存活机制问题;江原更愿意保留核心技术积累,同时接入大模型等AI工具替代重复性工作,提升研发效率。
这种克制背后,是提前布局。江原采用Chiplet路线搭建统一架构,可灵活组合不同规格Chiplet适配不同场景需求,缩短新产品落地周期;同时接入SLA和SLO等上层统一软件框架,推动硬件与算法解耦,保障产品向前兼容。标准层面,公司已参与相关人工智能、AI芯片标准制定,把100余家行业客户的适配经验反馈给标准制定方,推动标准从团标、地标向国标层级进阶。鲍敏祺在采访中说得很直接:“如果标准只是研究院闭门造车,最后很容易和整个行业需求对不上。”
市场判断上,江原当前更看好AIPC/AgentPC作为大模型核心入口,分为ToB垂类效率提升和ToC家庭智能管家两类形态;具身智能预计2029—2030年迎来集中爆发,当前仍处于数据采集、技术积累阶段,机器狗只是能力展示,并非主力市场。出海方面,公司优先聚焦国内,国内算力需求供不应求,海外地缘风险较高,暂未大规模拓展;会持续关注沙特、金砖国家等区域机会,待政策指引明确、应用落地路径清晰后再有序推进。
写在最后:价值不在“峰值”,在“算得清账”
在国产AI芯片这一波“百芯大战”里,江原科技不属于那种把“最亮眼峰值”挂在嘴边的公司。它更愿意反复讲的事情是:技术创新不以峰值参数为终点,而以商业可用为检验标准。围绕这条主线,江原的差异化至少有三处:路径上,先边端再云端,用边端客户养验证、养口碑,再自然承接云边协同需求;市场上,把“商业可用”做到最细,100余家客户、177种应用、60%软件通信加40%传统行业,信创入口已有税务稽查、机场行李检测等标杆项目,并取得《人工智能终端智能化分级》国家标准L3辅助级测评认证;研发节奏上,260人的团队拒绝盲目扩表,用AI工具、Chiplet统一架构和Vllm软硬件解耦压缩产品落地周期。
把这些叠在一起看,江原给自己的定位其实很清楚——“高质量token国产算力底座”。这不是一个追逐峰值FLOPs的故事,而是一个让技术创新始终锚定商业价值的工程化故事:客户能算得清账、能跑得通业务、能用得起国产替代。创新的方向已经明确,剩下的是让技术持续兑现为客户可感知的价值。